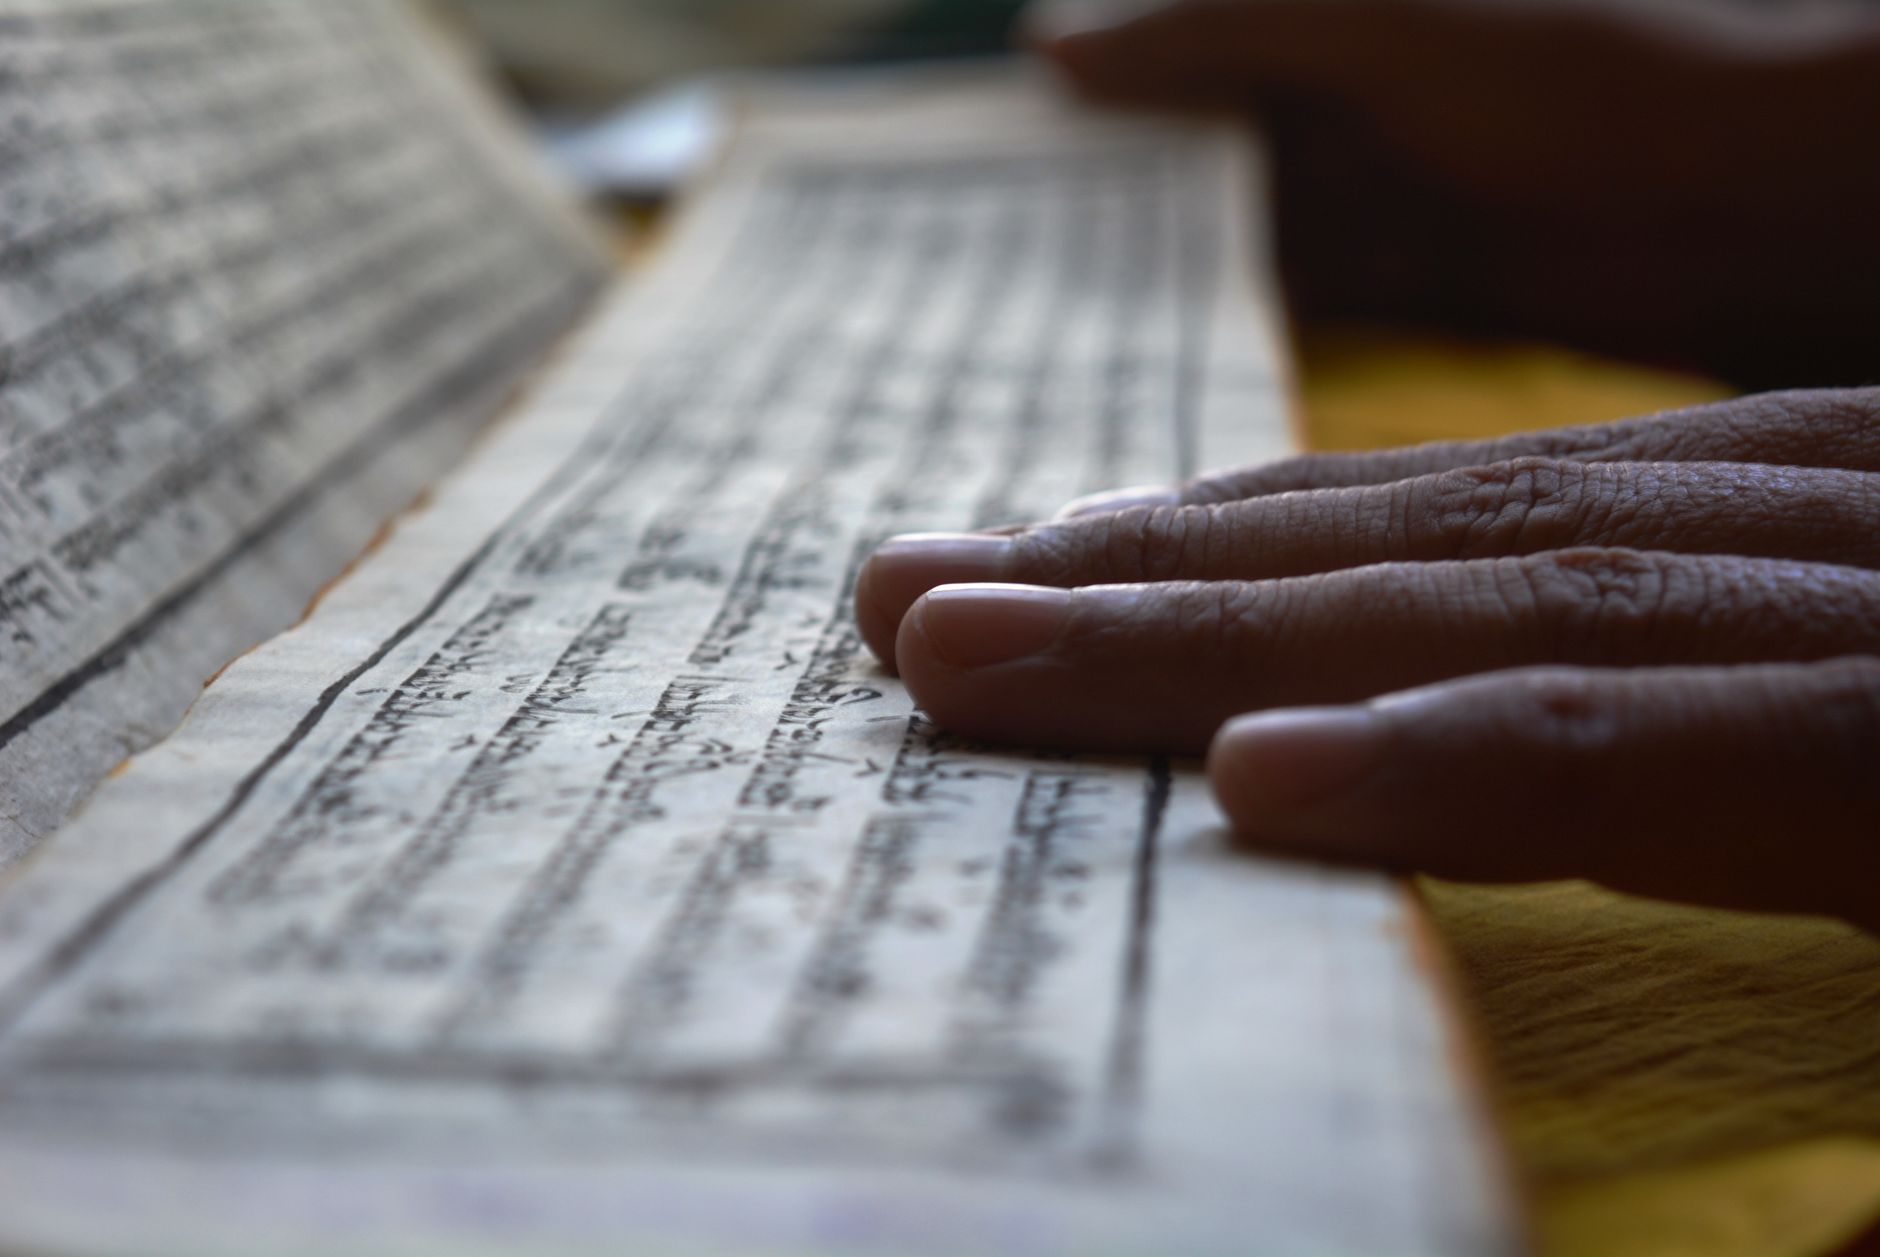
Las máquinas analizan patrones del Manuscrito Voynich, uno de los documentos más enigmáticos jamás descubiertos. El códice desafía a los criptógrafos desde hace más de un siglo y, custodiado en la Biblioteca Beinecke de Libros Raros y Manuscritos de la Universidad de Yale. Sigue siendo un acertijo sin resolver sobre la naturaleza del lenguaje y la intención humana.
Adquirido en 1912 y fechado entre 1404 y 1438 mediante radiocarbono, el volumen tiene 240 páginas con símbolos desconocidos, plantas imposibles, diagramas astronómicos y figuras humanas. Su mayor misterio es que ningún idioma registrado coincide con su contenido. Los criptógrafos más renombrados del siglo XX tampoco lograron descifrarlo.
Cómo la inteligencia artificial aborda el misterio
Ante el fracaso de los métodos tradicionales, los investigadores han recurrido a algoritmos y modelos de aprendizaje automático para buscar regularidades en el manuscrito. La IA funciona como una lupa estadística: busca patrones en los textos del códice al mapear la frecuencia de los símbolos y calcular la entropía de la escritura.
Los análisis computacionales han revelado que el texto no es fruto de combinaciones aleatorias: la distribución de las palabras sigue la ley de Zipf, un patrón estadístico característico de los lenguajes humanos. Según esta ley, pocas palabras aparecen con mucha frecuencia y la mayoría aparece rara vez.
Además, los términos específicos se agrupan según las secciones temáticas del volumen, como botánica o astronomía, esto indica que existe una estructura subyacente deliberada.
Las barreras que frenan el desciframiento
Según especialistas en inteligencia artificial consultados por el Metrópoles, la IA puede mostrar que existe una estructura, pero eso no equivale a descifrar el significado. Los algoritmos evalúan la frecuencia de los caracteres y la distribución de los términos sin lograr una decodificación verdadera, porque sigue faltando una referencia bilingüe similar a la Piedra de Roseta de los jeroglíficos egipcios.
Sin una clave externa o registros completos de idiomas antiguos extintos, los modelos corren el riesgo de indicar falsas correspondencias. El mayor desafío es la escasez de datos sobre lenguas antiguas, que reduce la precisión de las pruebas y aumenta el riesgo de producir una interpretación plausible pero falsa.
Investigadores también han explorado la posibilidad de que el manuscrito esté escrito en hebreo, con las letras organizadas en un patrón fijo. Otros entrenan sistemas de IA con versiones de la Declaración Universal de los Derechos Humanos en 380 idiomas diferentes para identificar el idioma probable del documento.
Nuevas pistas en el horizonte
En 2025, el investigador Michael Greshko demostró que el código Naibbe, un método manual de cifrado del siglo XV basado en datos y cartas. Puede replicar en latín e italiano las mismas propiedades estadísticas observadas en el manuscrito.
Este hallazgo abre nuevas hipótesis sobre la verdadera naturaleza del documento y sugiere que pudo ser producto de una técnica de cifrado sofisticada de aquella época.
Según informaron especialistas al Metrópoles, el avance depende de más potencia computacional, pero también de nuevas evidencias históricas. La respuesta definitiva puede venir de archivos históricos, no solo de algoritmos.
Aunque la tecnología amplía las oportunidades de análisis, aún no garantiza una resolución rápida ni demuestra si el texto es un mensaje cifrado, una lengua desconocida, una escritura artificial o una farsa. Hasta entonces, el libro sigue siendo el mayor desafío para el análisis lingüístico moderno.
¿Se ha descifrado ya la primera oración del manuscrito?
Investigadores de la Universidad de Alberta lograron descodificar una frase que sería la primera del manuscrito mediante la metodología de identificación hebrea combinada con el análisis de alfagramas. El resultado fue: «Ella hizo recomendaciones al padre, al hombre de la casa y a mí y al pueblo». Sin embargo, los propios especialistas reconocen que es una frase «bastante extraña».
Su comprensión genuina dependerá de futuros desciframientos que permitan validar si esta interpretación tiene sentido en el contexto del documento completo.